Trong hành trình chinh phục các công trình nghiên cứu khoa học, từ khóa luận tốt nghiệp, luận văn thạc sĩ đến các bài báo quốc tế, việc nắm vững và áp dụng chính xác các mô hình nghiên cứu định lượng là chìa khóa then chốt quyết định sự thành công. Đây không chỉ là công cụ để kiểm định giả thuyết mà còn là ngôn ngữ học thuật giúp bạn đối thoại với dữ liệu, khám phá những quy luật ẩn sau những con số. Tuy nhiên, đứng trước một “ma trận” các mô hình như Hồi quy, SEM, PLS-SEM, Dữ liệu bảng, nhiều nhà nghiên cứu trẻ không khỏi bối rối. Bài viết này được biên soạn bởi các chuyên gia của chayspss.com, sẽ là một cẩm nang toàn diện, hướng dẫn bạn từ A-Z về các mô hình nghiên cứu định lượng, từ lý thuyết nền tảng, thực hành chi tiết trên phần mềm, đến nghệ thuật biện luận kết quả.
Mô hình nghiên cứu định lượng là gì và tại sao lại quan trọng?
Trước khi đi sâu vào các kỹ thuật phức tạp, chúng ta cần hiểu rõ bản chất. Mô hình nghiên cứu định lượng là một cấu trúc logic, được biểu diễn bằng các phương trình toán học và thống kê, nhằm mô tả và kiểm định mối quan hệ nhân quả hoặc tương quan giữa các biến số trong một đề tài nghiên cứu. Các biến số này được lượng hóa thành các con số cụ thể thông qua quá trình thu thập dữ liệu (ví dụ: khảo sát bằng thang đo Likert, thu thập số liệu tài chính…).
Vậy tại sao chúng lại quan trọng đến vậy? Thứ nhất, các mô hình nghiên cứu định lượng cung cấp một phương pháp khách quan, khoa học để kiểm tra các giả thuyết đã được xây dựng từ lý thuyết nền. Thay vì dựa trên suy đoán cảm tính, mô hình cho phép chúng ta kết luận một mối quan hệ (ví dụ: “Sự hài lòng” tác động đến “Lòng trung thành”) có ý nghĩa thống kê hay không.
Thứ hai, chúng giúp lượng hóa mức độ tác động. Mô hình không chỉ trả lời câu hỏi “Có tác động hay không?” mà còn cho biết “Tác động mạnh hay yếu?”. Ví dụ, một mô hình hồi quy có thể chỉ ra rằng “Chất lượng dịch vụ” có tác động mạnh gấp đôi so với “Giá cả” lên quyết định mua hàng. Thông tin này cực kỳ giá trị cho cả giới học thuật và các nhà quản trị doanh nghiệp. Cuối cùng, việc sử dụng thành thạo các mô hình nghiên cứu định lượng thể hiện năng lực nghiên cứu chuyên nghiệp của tác giả, là một tiêu chí quan trọng để đánh giá chất lượng của một luận văn hay công trình khoa học.
Phân loại các mô hình nghiên cứu định lượng phổ biến nhất
Thế giới của các mô hình nghiên cứu định lượng rất đa dạng, việc lựa chọn mô hình nào phụ thuộc chủ yếu vào hai yếu tố: (1) Mục tiêu nghiên cứu của bạn là gì? (Kiểm định tác động trực tiếp, hay một hệ thống các mối quan hệ phức tạp?) và (2) Bản chất dữ liệu của bạn là gì? (Dữ liệu sơ cấp thu từ khảo sát, hay dữ liệu thứ cấp từ báo cáo tài chính?). Dưới đây là 5 nhóm mô hình kinh điển mà bất kỳ nhà nghiên cứu nào cũng cần nắm vững.
- Ghi chú: Sơ đồ minh họa mối liên hệ giữa loại dữ liệu và các mô hình tương ứng.
- Mô hình Hồi quy tuyến tính bội (OLS – Ordinary Least Squares): Đây là mô hình cơ bản và phổ biến nhất, thường được giảng dạy trong các môn Kinh tế lượng và Phương pháp nghiên cứu. OLS được dùng để xem xét tác động của nhiều biến độc lập lên một biến phụ thuộc duy nhất. Ví dụ: Phân tích các yếu tố (chất lượng sản phẩm, giá cả, quảng cáo) ảnh hưởng đến doanh thu. Phần mềm tối ưu cho mô hình này là SPSS.
- Mô hình cấu trúc tuyến tính SEM (Structural Equation Modeling): Đây là một kỹ thuật nâng cao, cho phép kiểm định một mạng lưới các mối quan hệ phức tạp cùng một lúc, bao gồm cả tác động trực tiếp, gián tiếp (trung gian) và điều tiết. SEM được chia thành 2 trường phái:
- CB-SEM (Covariance-Based SEM): Phù hợp với các nghiên cứu mang tính khẳng định lý thuyết (khi bạn đã có một mô hình lý thuyết nền vững chắc). Nó đòi hỏi cỡ mẫu lớn và dữ liệu phân phối chuẩn. Phần mềm “vua” trong lĩnh vực này là AMOS.
- PLS-SEM (Partial Least Squares SEM): Là giải pháp thay thế linh hoạt cho CB-SEM, đặc biệt hiệu quả khi cỡ mẫu nhỏ, dữ liệu không phân phối chuẩn, hoặc mô hình có tính khám phá, phát triển lý thuyết mới. SmartPLS là công cụ hàng đầu cho phương pháp này.
- Mô hình Dữ liệu bảng (Panel Data Models): Khi nguồn dữ liệu của bạn là dữ liệu thứ cấp được thu thập theo cả không gian (nhiều công ty, nhiều quốc gia) và thời gian (nhiều năm), đây là lúc mô hình nghiên cứu kinh tế lượng dạng bảng phát huy tác dụng. Nó giúp kiểm soát các yếu tố đặc thù không đổi của từng đối tượng, cho kết quả ước lượng tin cậy hơn. Các mô hình phổ biến bao gồm Pooled OLS, FEM (Fixed Effects Model), REM (Random Effects Model). STATA là phần mềm được ưa chuộng nhất cho loại phân tích này.
- Mô hình Chuỗi thời gian (Time Series Models): Dành riêng cho việc phân tích dữ liệu được thu thập theo trình tự thời gian của chỉ một đối tượng duy nhất (ví dụ: giá cổ phiếu VNM hàng ngày, tỷ lệ lạm phát của Việt Nam hàng quý). Các mô hình như ARDL, VAR, VECM giúp phân tích mối quan hệ động và dự báo các giá trị trong tương lai. EViews và STATA là hai công cụ mạnh mẽ cho mảng này.
Quy trình chuẩn bị và làm sạch dữ liệu: Nền tảng cho một mô hình đáng tin cậy
Câu nói “Garbage In, Garbage Out” (Rác vào, Rác ra) hoàn toàn đúng trong phân tích định lượng. Một bộ dữ liệu “bẩn” chứa đầy lỗi sẽ dẫn đến kết quả sai lệch, khiến mọi nỗ lực phân tích trở nên vô nghĩa. Trước khi chạy bất kỳ mô hình nào, bạn bắt buộc phải thực hiện quy trình làm sạch dữ liệu một cách cẩn thận. Đây là bước không thể bỏ qua khi áp dụng các mô hình nghiên cứu định lượng.
Đầu tiên là mã hóa dữ liệu (Coding). Bạn cần chuyển các câu trả lời từ phiếu khảo sát giấy hoặc Google Form vào phần mềm (thường là Excel hoặc SPSS) một cách có hệ thống. Mỗi câu hỏi quan sát sẽ trở thành một biến (ví dụ: CL1, CL2 cho nhân tố Chất lượng), và mỗi người trả lời là một dòng. Bước này đòi hỏi sự tỉ mỉ để tránh nhập sai số liệu.
Tiếp theo là xử lý giá trị khuyết (Missing Values). Người trả lời có thể bỏ sót một vài câu hỏi, tạo ra các ô trống trong bộ dữ liệu của bạn. Nếu tỷ lệ khuyết trên một biến rất nhỏ (dưới 5%), bạn có thể xem xét thay thế chúng bằng giá trị trung bình của biến đó (Mean Substitution) để không làm mất đi thông tin của các câu trả lời khác từ cùng một người. Nếu một người trả lời bỏ trống quá nhiều, việc loại bỏ hoàn toàn dòng dữ liệu đó (Listwise deletion) có thể là lựa chọn tốt hơn.
Cuối cùng, và cũng rất quan trọng, là phát hiện và xử lý các giá trị ngoại lai (Outliers). Outlier là những quan sát có giá trị khác biệt một cách bất thường so với phần còn lại của dữ liệu (ví dụ: trong thang đo từ 1-5, có người nhập nhầm thành 55). Chúng có thể làm méo mó kết quả phân tích. Công cụ trực quan như biểu đồ Hộp (Boxplot) trong SPSS giúp dễ dàng nhận diện các điểm này. Đối với các phân tích phức tạp hơn như hồi quy, khoảng cách Mahalanobis là một thước đo thống kê mạnh mẽ để xác định các quan sát có ảnh hưởng bất thường lên toàn bộ mô hình.
Hướng dẫn thực hành chi tiết phương pháp nghiên cứu định lượng trên phần mềm
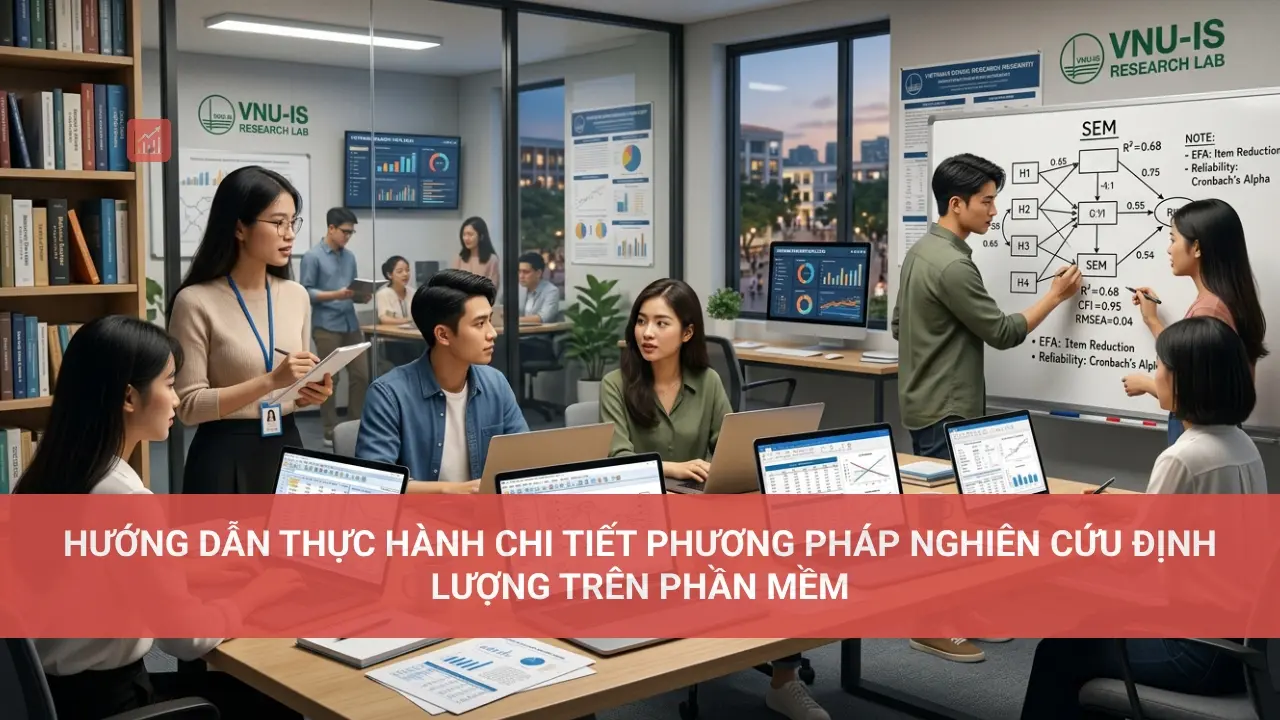
Lý thuyết sẽ chỉ là lý thuyết nếu không thể áp dụng vào thực tế. Phần này sẽ hướng dẫn bạn các bước cốt lõi để chạy những mô hình nghiên cứu định lượng thông dụng nhất trên các phần mềm chuyên dụng.
Lộ trình 1: Phân tích mô hình hồi quy định lượng với SPSS
Đây là lộ trình phổ biến nhất cho các bạn sinh viên làm khóa luận tốt nghiệp với dữ liệu khảo sát.
- Kiểm định độ tin cậy thang đo (Cronbach’s Alpha): Sau khi làm sạch dữ liệu, bước đầu tiên là đánh giá chất lượng thang đo. Vào
Analyze > Scale > Reliability Analysis. Đưa các biến quan sát của cùng một nhân tố (ví dụ: HL1, HL2, HL3, HL4) vào ôItems. Một thang đo được xem là tốt khi có hệ số Cronbach’s Alpha tổng > 0.7 và các hệ sốCorrected Item-Total Correlationcủa từng biến quan sát > 0.3. Nếu có biến nào không đạt, hãy xem xét loại bỏ nó và chạy lại Alpha. - Phân tích nhân tố khám phá (EFA): Bước này nhằm kiểm tra xem các biến quan sát bạn thiết kế có thực sự gom lại thành các nhân tố như lý thuyết hay không (kiểm định giá trị hội tụ và phân biệt). Vào
Analyze > Dimension Reduction > Factor. Đưa tất cả các biến quan sát của các nhân tố độc lập vào và thiết lập các tùy chọn quan trọng: KMO & Bartlett’s test (ởDescriptives), Principal Axis Factoring và Eigenvalues over 1 (ởExtraction), và phép quay Varimax hoặc Promax (ởRotation). Kết quả EFA được xem là tốt khi KMO > 0.5, Sig. của Bartlett < 0.05, và các biến quan sát tải lên đúng nhân tố của mình với hệ số tải (Factor Loading) > 0.5. - Phân tích Tương quan và Hồi quy: Sau khi EFA thành công, bạn tính giá trị trung bình đại diện cho mỗi nhân tố (
Transform > Compute Variable). Tiếp theo, dùngAnalyze > Correlate > Bivariateđể kiểm tra tương quan Pearson giữa các biến. Cuối cùng, chạy mô hình hồi quy chính thức tạiAnalyze > Regression > Linear. Tại đây, bạn sẽ có được hệ số Beta (mức độ tác động), Sig. (ý nghĩa thống kê), và R Square hiệu chỉnh (mức độ giải thích của mô hình).
Lộ trình 2: Tối ưu mô hình SEM phức tạp với AMOS và SmartPLS
Khi mô hình của bạn có biến trung gian hoặc điều tiết, hồi quy OLS không còn đủ mạnh. Đây là lúc SEM vào cuộc.
Ví dụ thực tế về sửa lỗi Model Fit trong AMOS:
Giả sử bạn chạy phân tích nhân tố khẳng định (CFA) cho mô hình của mình trong AMOS và nhận được kết quả đáng thất vọng: Chi-square/df = 4.8, CFI = 0.88, TLI = 0.86, RMSEA = 0.09. Tất cả đều không đạt ngưỡng khuyến nghị.
- Hành động: Đừng vội nản lòng. Mở kết quả output và tìm đến bảng
Modification Indices. Sắp xếp theo cộtM.I., bạn phát hiện ra một giá trị rất cao (ví dụ: 35.6) ở mối liên hệ giữa hai sai sốe8vàe9. - Phân tích: Bạn tra lại,
e8vàe9là phần sai số của hai biến quan sátTC5(“Chính sách hậu mãi tốt”) vàTC6(“Chính sách bảo hành rõ ràng”). Về mặt ngữ nghĩa, hai câu hỏi này rất gần nhau và cùng thuộc nhân tố “Tin cậy”. Việc chúng có phần phương sai sai số chung là điều có thể chấp nhận được. - Khắc phục: Quay lại giao diện vẽ mô hình, bạn dùng công cụ
Draw Covariancesđể vẽ một mũi tên hai chiều nối giữae8vàe9. Chạy lại mô hình. Rất có thể các chỉ số model fit sẽ được cải thiện đáng kể (ví dụ: Chi-square/df giảm xuống 2.9, CFI tăng lên 0.92, RMSEA giảm còn 0.07), giúp mô hình của bạn trở nên phù hợp hơn. Đây là một kỹ thuật tinh chỉnh các mô hình nghiên cứu định lượng rất hiệu quả.
Nghệ thuật đọc hiểu và biện luận kết quả nghiên cứu
Việc chạy ra một bảng kết quả chỉ là 50% công việc. 50% còn lại, và cũng là phần thể hiện đẳng cấp của nhà nghiên cứu, nằm ở khả năng diễn giải và biện luận những con số đó. Đây là bước biến dữ liệu thô thành tri thức khoa học.
Hãy bắt đầu với các chỉ số đánh giá chất lượng. Khi trình bày kết quả Cronbach’s Alpha, đừng chỉ viết “Cronbach’s Alpha của nhân tố A là 0.85 > 0.7 nên thang đo đạt yêu cầu”. Hãy viết một cách chuyên nghiệp hơn: “Kết quả kiểm định độ tin cậy thang đo cho thấy tất cả các nhân tố đều có hệ số Cronbach’s Alpha dao động từ 0.82 đến 0.91, vượt qua ngưỡng khuyến nghị 0.7 của Hair và cộng sự (2014). Điều này cho thấy các biến quan sát được sử dụng có tính nhất quán nội tại cao và đo lường tốt cho khái niệm nghiên cứu.”
Đối với kết quả kiểm định giả thuyết, sai lầm lớn nhất là chỉ liệt kê các con số. Thay vì nói “Biến X1 tác động dương đến Y (Beta = 0.4, p < 0.05)”, hãy biến nó thành một câu chuyện học thuật. Bạn cần so sánh kết quả của mình với các nghiên cứu trước đó và lý thuyết nền. Ví dụ: “Kết quả phân tích hồi quy cho thấy Chất lượng cảm nhận có tác động dương và có ý nghĩa thống kê đến Sự hài lòng của khách hàng (β = 0.45, p < 0.001). Phát hiện này hoàn toàn ủng hộ cho mô hình Chấp nhận Công nghệ (TAM) và tương đồng với các nghiên cứu thực nghiệm của Davis (1989) tại thị trường Mỹ cũng như của Nguyễn Văn A (2022) tại bối cảnh Việt Nam, khẳng định vai trò cốt lõi của chất lượng sản phẩm trong việc tạo dựng sự hài lòng.”
Một điểm quan trọng khác là hệ số R bình phương hiệu chỉnh (Adjusted R-squared). Con số này cho biết mô hình của bạn giải thích được bao nhiêu phần trăm sự thay đổi của biến phụ thuộc. Ví dụ, R² hiệu chỉnh = 0.624 có nghĩa là các biến độc lập trong mô hình giải thích được 62.4% sự biến thiên của biến phụ thuộc. Đây là một con số quan trọng để đánh giá sức mạnh tổng thể của toàn bộ mô hình nghiên cứu định lượng bạn đã xây dựng.
Giải quyết các “sự cố” thường gặp khi chạy các mô hình nghiên cứu
Con đường nghiên cứu không bao giờ trải hoa hồng. Dữ liệu thực tế thường phát sinh nhiều vấn đề không lường trước. Kỹ năng xử lý sự cố là điều bắt buộc đối với một nhà nghiên cứu giỏi.
Tình huống 1: Giả thuyết bị bác bỏ (p-value > 0.05)
Đây là nỗi “ám ảnh” của nhiều bạn sinh viên. Tuy nhiên, một kết quả không có ý nghĩa thống kê không có nghĩa là nghiên cứu của bạn thất bại.
- Nguyên nhân: Có thể do cỡ mẫu quá nhỏ, không đủ “sức mạnh” để phát hiện ra mối quan hệ. Hoặc đơn giản là trong bối cảnh cụ thể của bạn, biến đó thực sự không có tác động.
- Cách khắc phục: Tuyệt đối không “nấu số liệu” để p < 0.05. Hãy dũng cảm đối mặt với kết quả. Biện luận một cách học thuật: “Trái với kỳ vọng và một số nghiên cứu trước, yếu tố ‘Thiết kế bao bì’ không cho thấy tác động có ý nghĩa thống kê đến ‘Ý định mua’ (p > 0.05). Điều này có thể được lý giải bởi đặc thù của nhóm khách hàng mục tiêu trong nghiên cứu này là Gen Z, những người có xu hướng ưu tiên đánh giá từ cộng đồng (review) và giá trị cốt lõi của sản phẩm hơn là hình thức bên ngoài.” Một biện luận sắc bén còn giá trị hơn một kết quả “đẹp” nhưng giả tạo.
Tình huống 2: Hiện tượng đa cộng tuyến (VIF > 10)
Trong mô hình hồi quy, khi các biến độc lập có tương quan quá chặt chẽ với nhau, chúng sẽ “tranh giành” ảnh hưởng lên biến phụ thuộc, làm cho kết quả ước lượng không còn đáng tin cậy. Dấu hiệu nhận biết là hệ số VIF (Variance Inflation Factor) trong bảng kết quả SPSS lớn hơn 10 (hoặc một số tiêu chuẩn khắt khe hơn là > 5 hoặc > 2).
- Giải pháp:
- Loại bỏ một trong các biến có tương quan quá cao với nhau (dựa vào ma trận tương quan Pearson).
- Kết hợp các biến bị đa cộng tuyến thành một nhân tố mới duy nhất thông qua phân tích EFA.
- Chuyển sang sử dụng phương pháp nghiên cứu định lượng PLS-SEM bằng phần mềm SmartPLS, vì thuật toán của PLS-SEM ít bị ảnh hưởng bởi vấn đề đa cộng tuyến.
Bí quyết nâng tầm luận văn với mô hình nghiên cứu định lượng
Để đạt điểm tối đa từ hội đồng, ngoài việc chạy đúng mô hình và có kết quả tốt, bạn cần thể hiện sự am hiểu sâu sắc và tuân thủ các chuẩn mực học thuật.
Đầu tiên, hãy biện luận kích thước mẫu một cách khoa học. Đừng bao giờ viết những lý do chung chung như “do hạn chế về thời gian và nguồn lực”. Thay vào đó, hãy trích dẫn các quy tắc kinh điển. Ví dụ: “Theo Hair và cộng sự (2010), cỡ mẫu tối thiểu cần gấp 5 lần tổng số biến quan sát. Với 30 biến quan sát trong mô hình, cỡ mẫu tối thiểu là 150. Nghiên cứu này đã thu thập được 250 phiếu hợp lệ, hoàn toàn đáp ứng yêu cầu về kích thước mẫu.” Cách viết này cho thấy bạn có nghiên cứu và lựa chọn cỡ mẫu một cách có chủ đích.
Thứ hai, trình bày bảng biểu chuẩn APA. Đây là tiêu chuẩn vàng trong trình bày khoa học. Các bảng biểu trong Word không nên có các đường kẻ dọc, chỉ giữ lại 3 đường kẻ ngang chính. Luôn ghi rõ tên bảng, số thứ tự và nguồn dữ liệu bên dưới (ví dụ: Nguồn: Kết quả xử lý từ SPSS 26.0 của tác giả). Sự chỉn chu trong hình thức phản ánh sự nghiêm túc trong nội dung.
Cuối cùng, hãy luôn nhớ rằng các mô hình nghiên cứu định lượng chỉ là công cụ. Giá trị thực sự của nghiên cứu nằm ở phần biện luận và hàm ý quản trị. Sau khi trình bày kết quả, hãy dành một chương riêng để trả lời câu hỏi: “Vậy thì sao?”. Từ kết quả “Chất lượng dịch vụ tác động mạnh nhất đến sự hài lòng”, bạn phải đề xuất được các hàm ý cụ thể cho doanh nghiệp: “Do đó, ban lãnh đạo công ty ABC nên ưu tiên phân bổ ngân sách cho các chương trình đào tạo nhân viên, cải tiến quy trình chăm sóc khách hàng thay vì chỉ tập trung vào các chiến dịch giảm giá.”
Hy vọng rằng cẩm nang chi tiết này đã cung cấp cho bạn một cái nhìn tổng quan và hệ thống về các mô hình nghiên cứu định lượng. Quá trình phân tích dữ liệu có thể phức tạp và tiềm ẩn nhiều thách thức. Nếu bạn gặp khó khăn trong việc lựa chọn mô hình, xử lý dữ liệu trên SPSS, AMOS, SmartPLS, hay lúng túng trong việc biện luận kết quả, đừng ngần ngại. Đội ngũ chuyên gia giàu kinh nghiệm của ChaySPSS.com luôn sẵn sàng tư vấn và đồng hành cùng bạn trên con đường chinh phục đỉnh cao học thuật.